
AI 3D建模工具: Tripo 3D | Meshy AI
一句话结论:text-to-3D 工具能很快返回一个「符合 glTF 规范」的 GLB,但规范合法不等于资产可用——文件可能高得离谱、沉在地面以下,或者在错误的轴上转了 90°。而这些都能用一段小脚本在进入生产管线之前拦住。
How to Validate a Text-to-3D GLB's Scale and Orientation Before It Enters Your PipelineWhat If Your .gltf File Is Too Large? A Practical Guide to 3D Model Optimization
一、为什么「合法 glTF」不等于「可用资产」
源文 ① 的出发点很直接:生成器给你的是一个规范合法的 GLB,但它并不保证单位、枢轴(pivot)、向上轴(up-axis)或三角面预算——这些只由文件自己声明,没人替你核对。
生成器实际给你的东西:
- 一个可以旋转查看的带贴图 GLB;
- 你填写的提示词,以及你自己给出的公制尺寸提示(subject size);
- 除此之外,没有关于单位、枢轴、朝向的承诺。
所以要做的事只有一件:把生成结果变成一个可以判定的问题。
第 1 步:生成一个候选,并记录请求
把需求写具体,并用米给出期望尺寸——这是后面唯一可以对照的固定参考:
- Brief:
compact probe droid on four struts, brushed metal and off-white panels, no text - Subject size(期望尺寸):
1.2米
保存返回的 GLB,不要跳过「记录期望尺寸」这一步。
第 2 步:读取文件声明的包围盒
解析 GLB 的 accessors,算出世界坐标包围盒。一个不依赖任何库的检查就够起步:
import { readFileSync } from "node:fs";
const glb = readFileSync("droid.glb");
// glTF 2.0 二进制头:magic、version、length(12 字节),
// 之后是 chunks:length、type、data。
const jsonLen = glb.readUInt32LE(12);
const jsonType = glb.readUInt32LE(16);
if (glb.readUInt32LE(0) !== 0x46546c67) throw new Error("not a GLB");
const json = JSON.parse(glb.subarray(20, 20 + jsonLen).toString("utf8"));
console.log("meshes", json.meshes.length, "nodes", json.nodes.length);
真正做门禁时,把文件过一遍 Khronos 的 gltf-validator,读取 asset.minVersion,再计算每个轴上的 min/max。注意:声明的边界只有在导出器按米写入时才等于米,很多 AI 导出器写的是无单位数字。
第 3 步:把声明尺寸和需求对比
const box = { x: [ -0.55, 0.55 ], y: [ 0, 1.15 ], z: [ -0.5, 0.6 ] }; // 来自 validator
const height = box.y[1] - box.y[0];
const expected = 1.2;
if (Math.abs(height - expected) / expected > 0.25) {
  throw new Error(`scale off: ${height.toFixed(2)}m vs ${expected}m`);
}
25% 的容差足以抓住两类经典错误:以英寸导出的零件(差 25.4 倍)、把米当毫米(差 1000 倍)。如果偏差刚好是一个干净的倍数,去修导入单位,而不是靠眼睛把模型缩放一下。
第 4 步:门禁朝向与枢轴
同一个脚本里再加两个断言:
- 向上轴:模型应当站在最低平面上,即
min.y接近 0。如果min.y是很负的值,说明枢轴悬在网格上方,资产会"穿过地板"。 - 朝向:确认一个前向轴约定(例如 -Z 为前),并断言"机头"顶点在预期的一侧。导出器不一致时,在导入时旋转一次并记录该变换。
第 5 步:放进 CI
把第 2–4 步包成一个函数,任何一条不通过就让构建失败。同时记录 { triangles, materials, textures, bbox, upAxis, pivot },这样被拒绝的资产有一份可对比的记录。这和后端的 lint 是同一种思路:一道廉价的闸门,阻止一次坏导出污染所有场景。
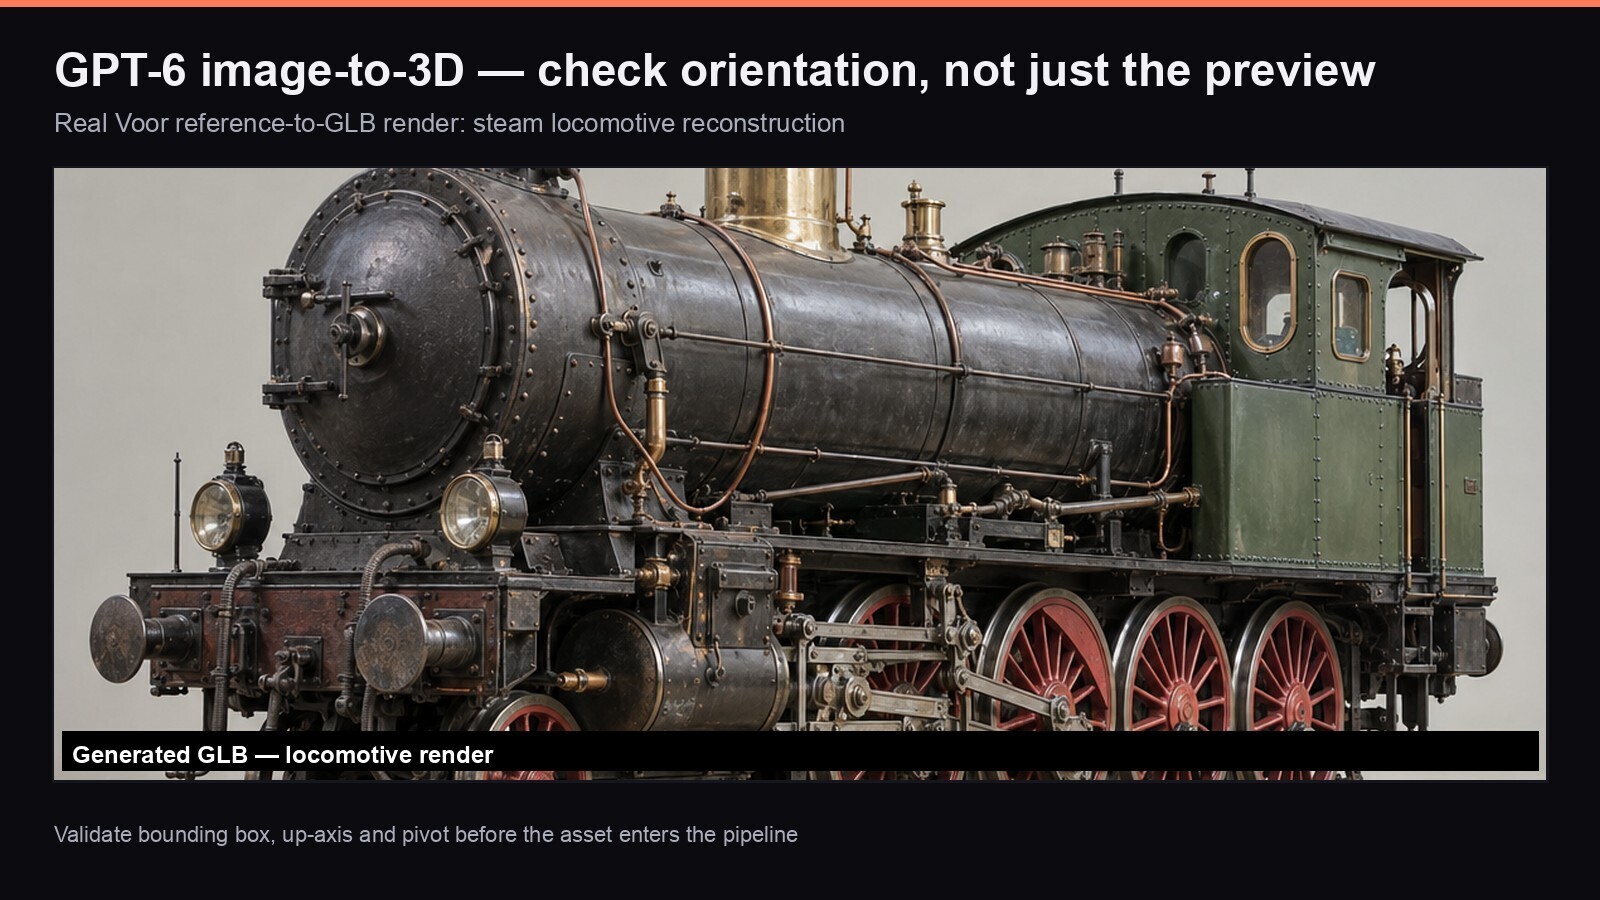
复核清单(源文原表)
- GLB magic 与 version 能正常解析,不抛异常;
- 声明的包围盒与需求的尺寸偏差在 25% 以内;
min.y在地平面附近,枢轴在底部;- 前向轴符合引擎约定,或已应用并记录导入旋转;
- 三角面数在目标平台预算之内。
局限(源文特别强调)
GPT 6 Astra 这类生成器每次只给一个候选、不暴露单位与变换约定,上面所有数字都来自你自己的校验,不是模型给的。另外,AI 网格可能带有非常薄的细节——能过包围盒检查,却在打印或碰撞测试中失败。把校验当作必要条件,而不是充分条件。
二、.gltf 太大怎么办:先优化源模型
源文 ② 的观察:.gltf 以"轻量"著称,但在真实项目里,来自 3D 扫描、BIM 导出或复杂工业装配的模型,很容易长到几十甚至上百 MB。
它为什么适合实时场景
glTF 用 JSON 描述整个场景:几何、材质、动画、骨骼,贴图以外部引用或二进制资源分离存放——这种"轻量"设计专注于运行时的加载与解析效率,而不是离线渲染的画质上限。典型用途:
- Web3D 可视化(Three.js、Babylon.js 等);
- AR / VR 交互体验;
- 数字孪生系统;
- 轻量化的产品展示网站;
- 游戏引擎中的实时资产加载。
优化三步(源文推荐的做法)
源文的做法是:不直接对 .gltf 文件动手,而是先把源模型做轻量化,再让它进入实时管线。
- 导入:工具自动分析模型结构、材质与贴图关系;
- 选择优化项:通常先调减面(polygon reduction),再做模型与材质合并。源文强调——复杂场景的性能瓶颈往往不在面数,而在 draw call 过多;合并重复模型与材质能显著减少渲染批次。对大量重复物体(管道、螺栓、树木、模块化建筑构件)启用 GPU instancing,让相似对象共享渲染逻辑;
- 预览:优化完成后先预览结果,确认外观没有明显损失再导出。
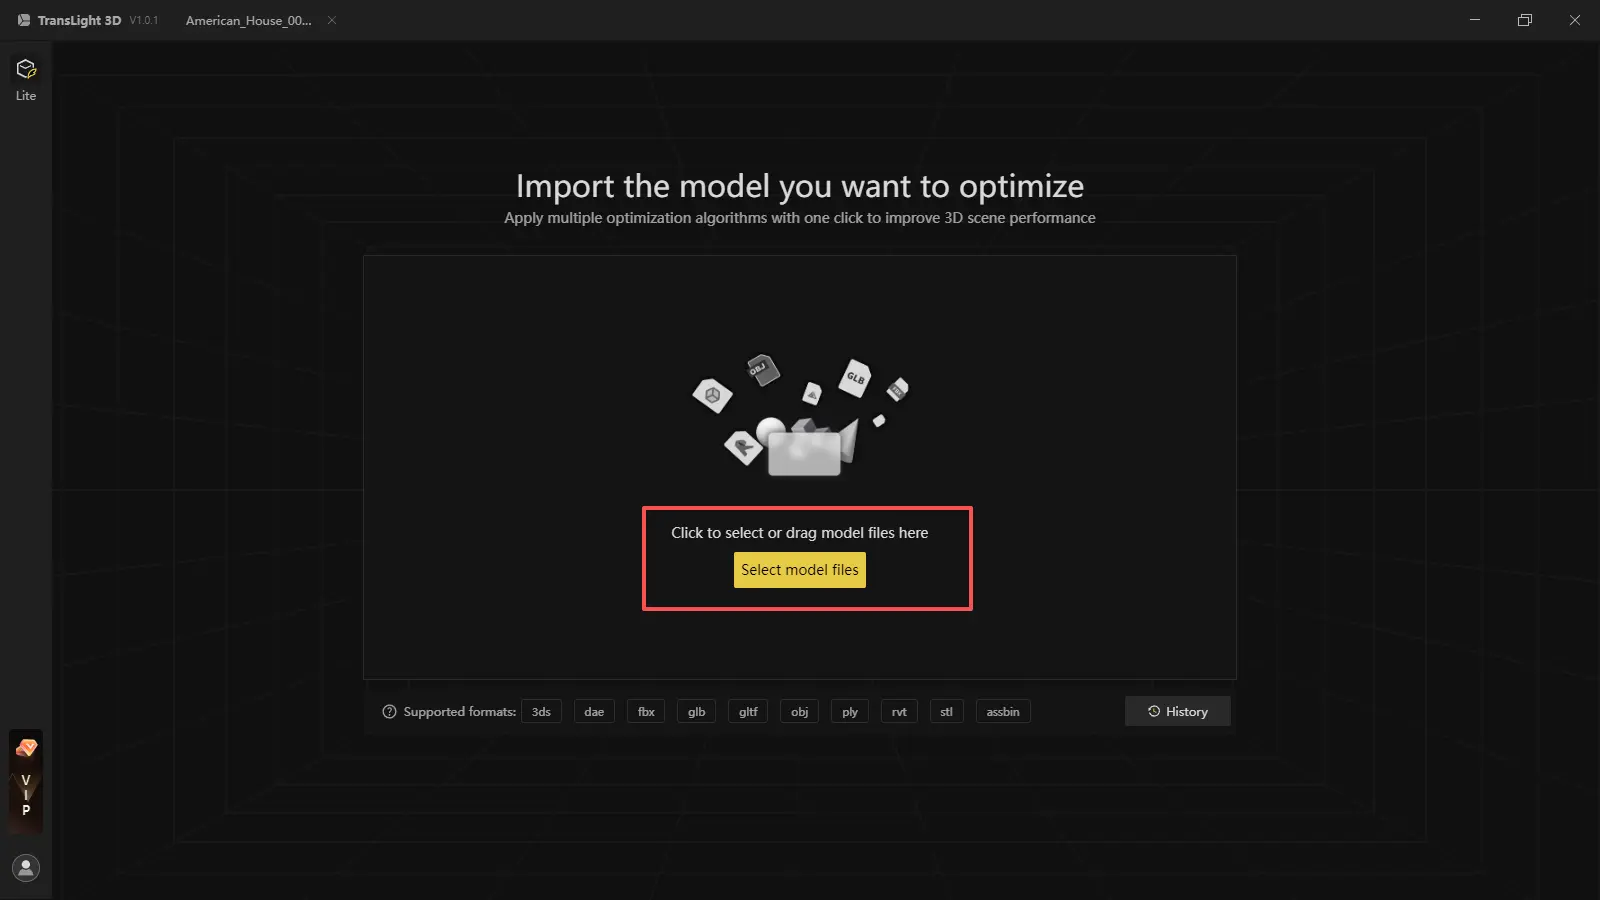
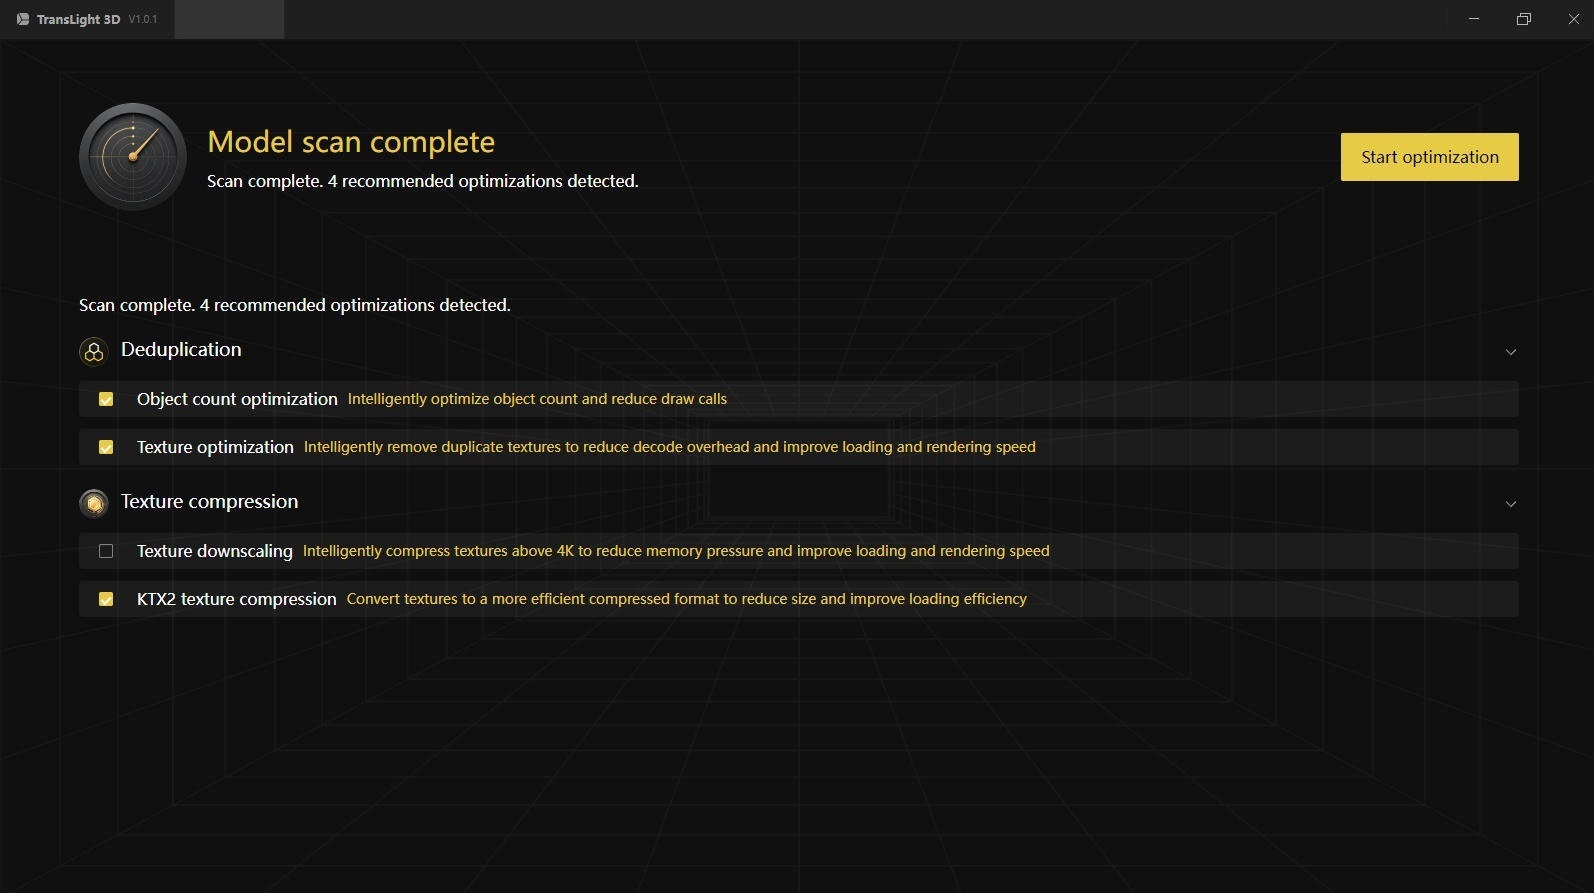
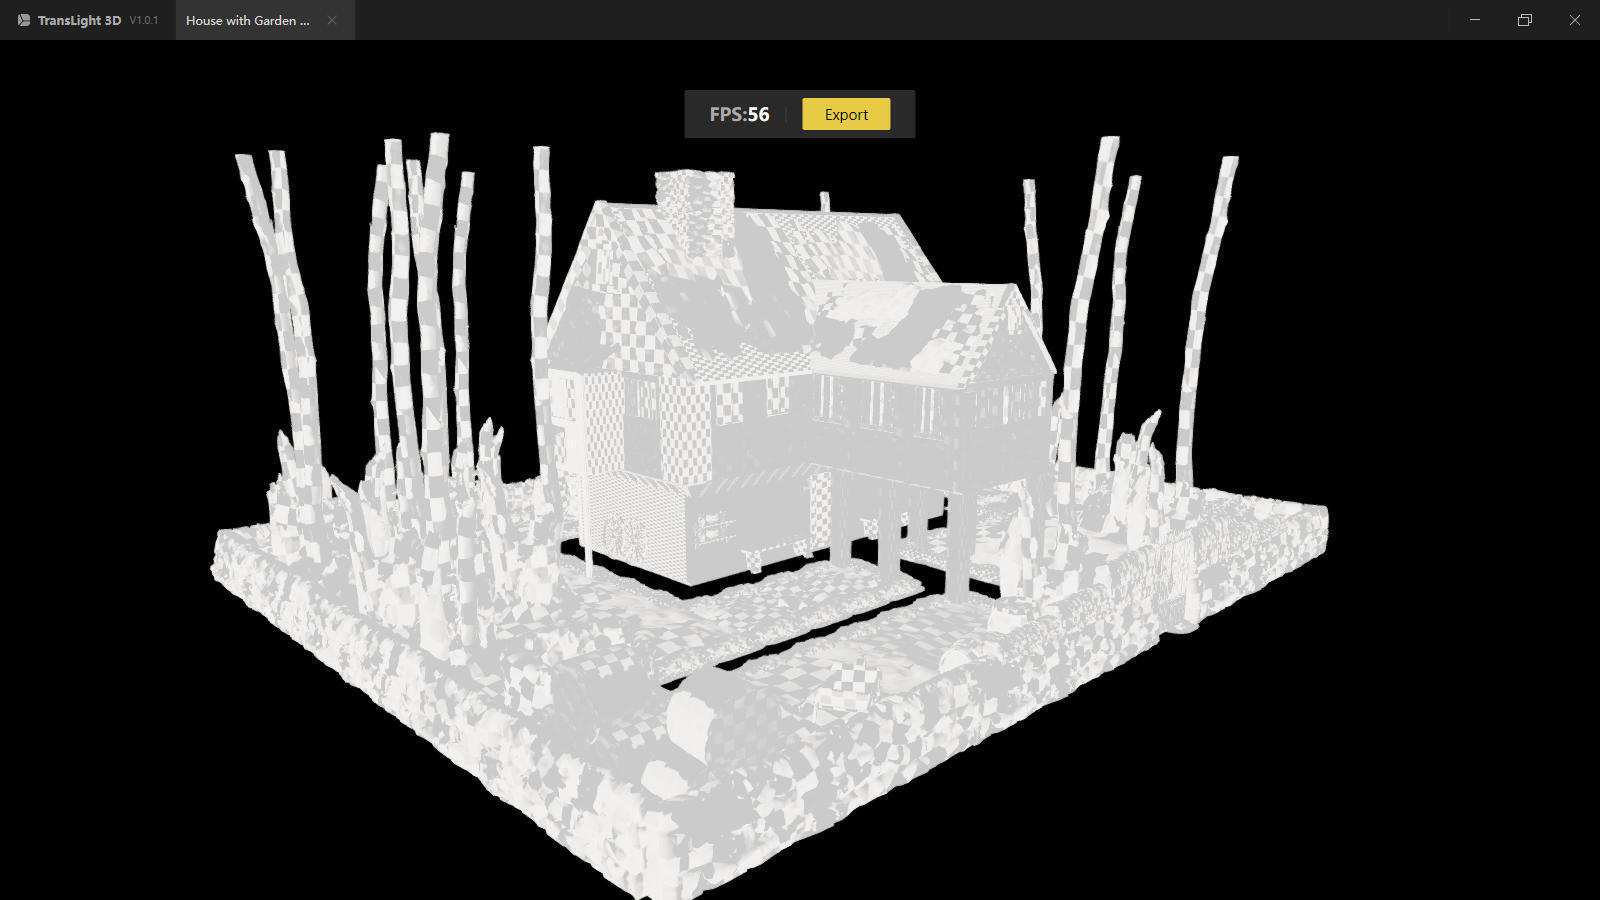
结论
.gltf 是实时渲染的优秀格式,但实际表现高度依赖源模型是否被正确优化。先轻量化、再交付,3D 内容才不会卡在加载页上——优化不只是加载更快,它直接决定浏览器、数字孪生、AR/VR 里的用户体验。
三、在线查看与验证(BimAnt 工具)
按源文的思路,拿到文件先做「可判定的检查」,再进引擎。BimAnt 提供两个在线入口:
- glTF Viewer 2.0(查看 + 模型验证报告):拖入 GLB/glTF 即可预览,验证报告会指出结构问题(缺失资源、非法索引、扩展声明不完整等);
- 3D Viewer(STL / OBJ / GLB / glTF / FBX 通用查看):用于跨格式快速比对。
建议顺序:验证报告 → 包围盒/尺寸核对 → 进入引擎或用例。这与源文①的 CI 门禁是同一逻辑,只是先在线跑一遍。
常见问题
Q:只做一项校验的话,先做哪个?先做包围盒与期望尺寸的对比。它是"模型能不能用"的第一道闸门,而且能立刻暴露单位错误。
Q:为什么我的模型在查看器里正常,导入引擎却出错?查看器容错更宽。以验证报告/validator 为准,先修结构问题,再排查引擎兼容性。
Q:Draco/meshopt 压缩和"减面/合并"是什么关系?源文②的优化是内容层(减面、合并、实例化),Draco/meshopt 是编码层(把同样的几何压得更小)。两者叠加效果最好,但编码压缩救不了面数与 draw call 本身。
来源: - How to Validate a Text-to-3D GLB's Scale and Orientation…(dev.to,2026-09-15) - What If Your .gltf File Is Too Large? A Practical Guide to 3D Model Optimization(dev.to,2026-06-17)
相关阅读:glTF 2.0 在线查看工具 | 用 Draco 压缩 3D 模型 | GLTF 模型简化 | 3D 格式与在线查看完全指南
本文由 BimAnt 编译整理,转载请注明出处。最后更新:2026-10-15
本文属于「3D 格式与查看器」专题。查看专题全部文章 →


