
AI 3D建模工具: Tripo 3D | Meshy AI
TLDR仓库在这里
引言
3D 生成在机器人、仿真、媒体与娱乐里有大量用途。在这些领域里,让生成的物体遵守严格规则、并统一模型与数据表示,都很困难。文件格式有很多,比如 GLB 和 PLY。表示方法也有很多,比如神经辐射场(NeRF)和 3D 高斯泼溅(3DGS)。每种都有自己的优缺点。
TRELLIS 提出了一种统一的内部表示,叫统一隐表示(unified latent representation)。它的解码器把这种表示转换成所需输出格式的 3D 模型。这样你就不必为每种表示格式用不同的模型。
同一个团队随后发布了 TRELLIS.2,改进了模型对 3D 结构的表示。但两个模型都没有提供把它适配到某个特定任务的简便方法。
我们想改进什么
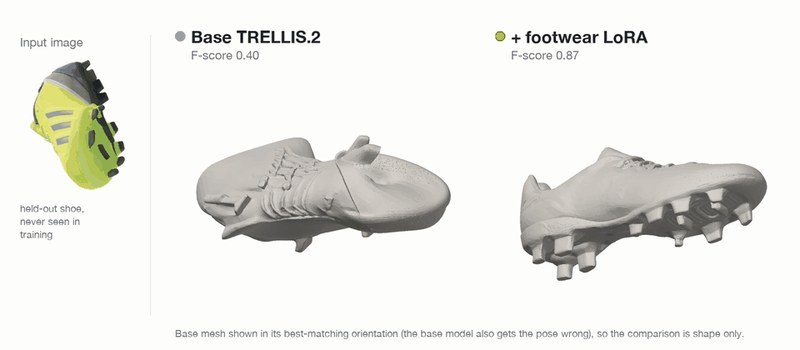
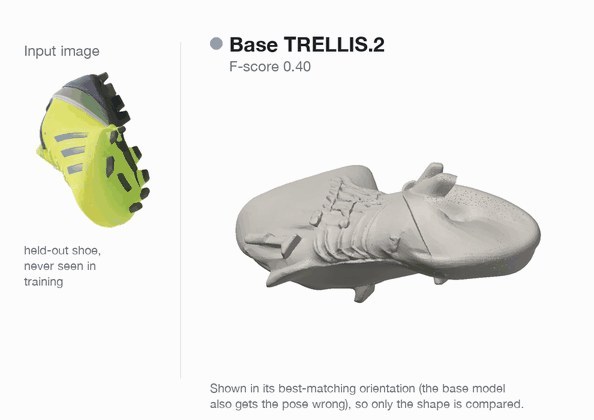
像 TRELLIS.2 这样的通用模型,可能在细节上出错,而这些细节对某个具体应用很重要。例如,用户可能需要家具模型的精确几何。不做针对性微调时,预训练模型可能产出精度不足的几何。我们的实验用 GSO 中 188 个鞋类对象组成的子集。在最初的测试里,预训练模型通常生成看起来正确的鞋,但鞋底是错的。我们测试 LoRA 能否让鞋底更准确。
我们的目标是用 Google Scanned Objects(GSO)数据集,提升 TRELLIS.2 在某个特定物体类别上的表现。我们会说明训练时哪些管线组件要微调、哪些要保留不动。这条管线把结构、细节几何与材质分开。因此我们只微调对任务重要的组件。
选择冻结什么,和选择微调什么同样重要。
我们会用到什么
LoRA
LoRA(low-rank adaptation,低秩适配)通过训练小的适配矩阵、同时保持原权重冻结来微调模型。这减少了可训练参数的数量,以及它们所需梯度和优化器状态的内存。我们用 Hugging Face 的 PEFT 库来加入并训练这些适配器。更多信息见我们的 LoRA 指南。
Hugging Face Jobs
Hugging Face Jobs 在云硬件上运行容器化负载。我们用它做预处理和训练。想用你自己的 GPU,见下面的本地 Docker 命令。开始之前,确认你有:
- 一个 HF_TOKEN,可以在这里获取;
- 你的 Hugging Face 账号必须有 DINOv3 的访问权限,因为 DINOv3 是受限(gated)模型;
- 如果你用自己的数据集,开始前先把它的网格上传到 Hub。
TRELLIS.2 是怎么工作的
训练之前,先看 TRELLIS.2 如何生成一个 3D 物体,以及我们要把 LoRA 适配器加在哪里。
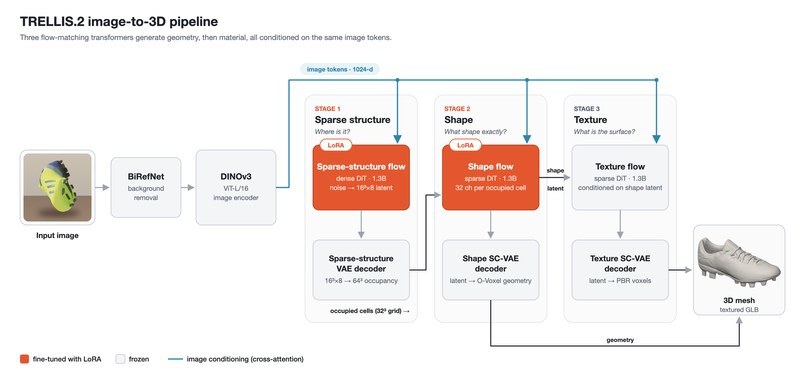
TRELLIS.2 有五个主要阶段:去掉图像背景、编码图像、预测粗结构、生成细节几何、生成材质。然后管线把结果导出为一个带贴图的网格。
编码输入图像
首先,BiRefNet 去掉输入图像的背景。然后 DINOv3-L 把图像编码成特征 token。生成模型用这些 token 来引导 3D 物体。
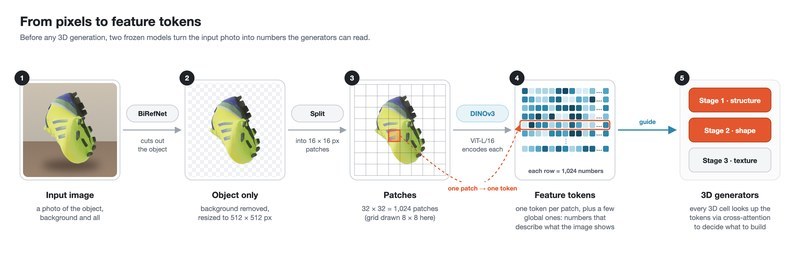
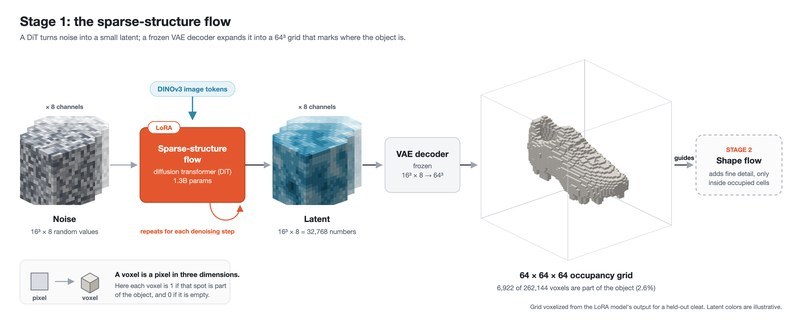
稀疏结构生成(Sparse Structure Flow)
稀疏结构流 DiT 预测物体的粗形状。它是一个扩散 transformer(DiT),产出一个尺寸为 16³ × 8 的小隐表示。随后一个变分自编码器(VAE)解码器把这个隐表示变成 64 × 64 × 64 的占据栅格。栅格里的每个体素表示该位置是否属于物体。体素就是三维里的像素。我们给这个模型加 LoRA 适配器,因为它的输出会引导几何阶段。
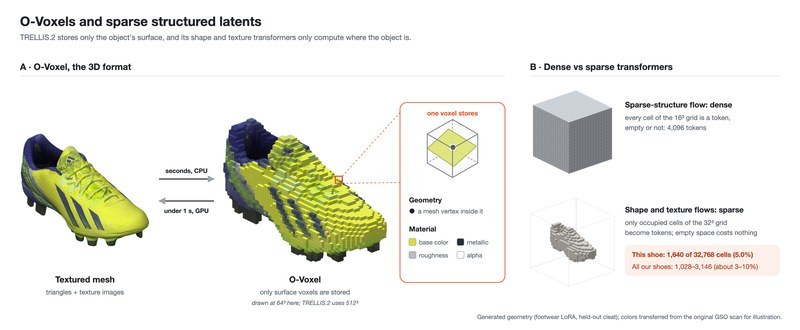
O-Voxel 与结构化隐表示
O-Voxel 是 TRELLIS.2 的 3D 格式。它是一个稀疏体素栅格,只保留物体表面上的体素。每个体素保留局部几何(比如网格顶点)与材质属性。因为格式很小,CPU 把网格转成 O-Voxel 只要几秒,GPU 把 O-Voxel 转回网格也只要几秒。
结构化稀疏隐表示来自 TRELLIS。它们把 3D 数据存在稀疏张量里,让计算更快。模型只用到栅格里约 10% 的体素,所以不会在空体素上花算力。因此,形状流 DiT 与纹理流 DiT 是稀疏 transformer,而稀疏结构流 DiT 是稠密 transformer。
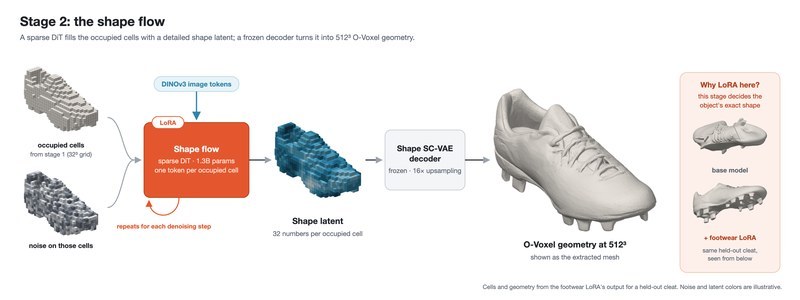
几何生成(Shape Flow)
形状流 DiT 用占据栅格和 DINOv3 特征 token 生成一个隐表示。另一个 VAE 解码器把这个隐表示变成 512 × 512 × 512 的 O-Voxel 几何。
我们给这一阶段的 DiT 加 LoRA 适配器,因为它控制物体的形状。
材质生成与网格创建
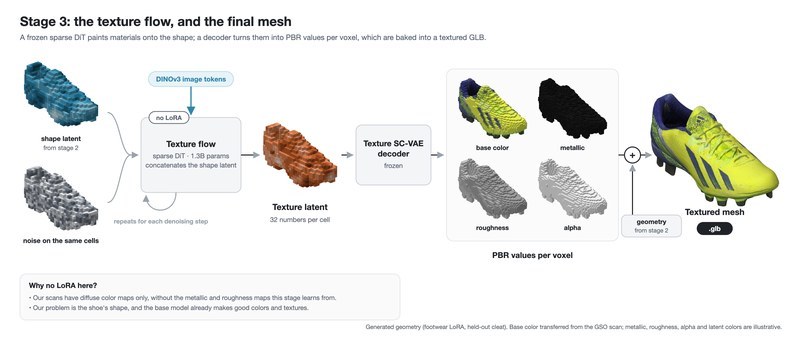
最后一个阶段,纹理流 DiT 以形状隐表示和 DINOv3 特征作为输入,定义几何表面的材质与贴图。随后一个 VAE 解码器把隐表示变成每个体素的基础色、金属度、粗糙度与 alpha 值。我们不给这一阶段加 LoRA 适配器。 我们的数据集有漫反射颜色贴图,但缺少这一阶段训练所需的独立材质贴图。而且我们的问题在鞋的形状;基础模型已经能做出不错的颜色和贴图。
最后,管线把几何与材质属性合成一个带贴图的网格,导出为 GLB 文件。
规划
微调哪些组件
我们只给稀疏结构流 DiT 和形状流 DiT 加 LoRA 适配器。这两个 DiT 控制物体的形状与几何。我们冻结纹理流 DiT,以保留它现有的能力。
我们的数据集包含的漫反射颜色贴图带有烘焙进去的光照效果。要训练纹理流 DiT,需要独立的材质贴图。我们数据集里的颜色贴图把表面颜色与光照混在一起,所以它们不是这次训练的正确目标。
如果拿这些贴图训练纹理流 DiT,它可能学会把光照当成表面属性,也可能忘掉它以前学到的东西——这个问题叫灾难性遗忘。
为什么用 LoRA
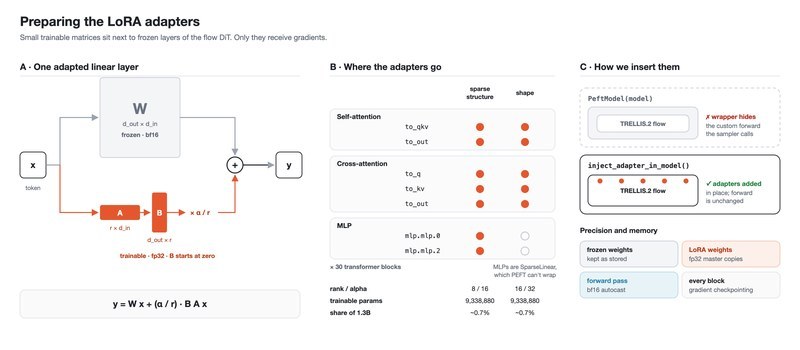
我们的子集是 GSO 里 1,030 个对象中的 188 个鞋。对这么小的数据集,LoRA 比全量微调更合适。全量微调贵得多,也可能覆盖掉模型本来擅长的东西(它学到的先验)。我们的配置为这两个目标 DiT 合计训练约 930 万个适配器参数。我们在稀疏结构流 DiT 的注意力层与前馈(MLP)层里用 rank 8 适配器;在形状流 DiT 的注意力层里用 rank 16 适配器。rank 决定适配矩阵的大小;rank 越高,适配器能学到的东西越多。
你要跑什么
一个 3D 模型的部署可能需要很多依赖和安装步骤。我们提供两个 Docker 镜像(可以在 Jobs 或你自己的机器上跑),里面装好了必要的软件。一个镜像做预处理,一个做微调。
要训练 LoRA 适配器并把它们上传到 Hub:
- 让容器能访问你的数据;
- 设定你任务的参数;
- 跑预处理容器;
- 跑微调容器。
然后我们会解释微调脚本、它的设置,以及每个设置如何影响训练。
实验概览
我们会走实验的三个部分:
- 准备数据。 把 GLB 或 OBJ 网格转换成 TRELLIS.2 训练所用的隐表示,并渲染输入图像。
- 训练适配器。 为每个 DiT 各跑一个任务,用准备好的数据集和一份 LoRA 配置。
- 讲清代码。 看容器如何加载数据、加入适配器、训练模型。
我们保存预处理后的数据集,让所有训练运行都能复用它。
实操
在 Hugging Face Jobs 上运行
预处理
预处理容器用 Blender 为每个对象渲染 16 个视角。LoRA 训练会用这些视角作为条件图像。Blender 通过 xvfb-run 工具无显示运行。容器还会把每个对象过一遍预处理管线。中间产出的例子见鞋类数据集。我们的 188 个对象,整轮在 a100-large 任务上大约跑了 1 小时。预处理管线还有一个精简版,在这个配套仓库里。
export HF_TOKEN=hf_xxx

# 把 your-username 换成你的 Hugging Face 用户名

hf jobs run -d --flavor a100-large --timeout 6h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-prep:latest \
  trellis2-prep \
    --meshes your-username/my-meshes \
    --push-to your-username/my-meshes-trellis2 \
    --private --holdout 0.05 \
    --views 16 --workers 8
对 Hugging Face Jobs,我们传这些参数:
| 参数 | 含义 |
|---|---|
| -d | 分离(detach):打印任务 ID 与 URL 后返回。要跟踪任务,运行 hf jobs logs -f <id> |
| --flavor a100-large | 硬件。我们用 a100-large(80 GB)。看所有选项运行 hf jobs hardware |
| --timeout 6h | 到时间任务停止。两条命令都会续跑:预处理跳过已完成对象,训练从 --push-to 里最新的检查点继续 |
| --secrets HF_TOKEN | 把你的 token(来自 HF_TOKEN 或 hf auth login)以加密环境变量形式发给任务。token 不会被写进镜像 |
| cr.hf.co/...:latest | 要运行的镜像。它后面的所有文本就是在容器里执行的命令 |
这个容器还接受另外几个参数(无论在 Hugging Face Jobs 还是 Docker 里跑都一样),文档在这里。预处理管线里执行的步骤,本文后面有一节说明。
LoRA 微调
训练容器加载准备好的数据集和一份配置预设或配置文件。它用 Trackio 记录训练指标。用 Trackio 面板监控运行。
我们用 ss 和 shape 表示训练 LoRA 的两种模式。ss 模式只微调稀疏结构流 DiT,shape 模式微调形状流 DiT。在底层,它们只是引用不同阶段的 config.json 文件。流程细节见本文后面一节。
export HF_TOKEN=hf_xxx  # 把 your-username 换成你的 Hugging Face 用户名

hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config ss \
    --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora \
    --run-name ss_lora \
    --push-path ss_lora \
    --trackio-space your-username/trellis2-trackio

hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config shape \
    --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora \
    --run-name shape_lora \
    --push-path shape_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
如果设置了 --push-to,容器会把适配器检查点上传到 Hub。容器接受的参数也在这里有文档。精简脚本在同一个仓库里。
如果你想拿我们已经处理好的数据集试着微调,可以直接用下面这组命令。
export HF_TOKEN=hf_xxx

# 把 your-username 换成你的 Hugging Face 用户名

# 稀疏结构流 DiT
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config ss \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --run-name ss_lora \
    --push-path ss_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500

# 形状流 DiT
hf jobs run -d --flavor a100-large --timeout 12h --secrets HF_TOKEN \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config shape \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --run-name shape_lora \
    --push-path shape_lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
用 Docker 本地运行
预处理:命令与参数和 Hugging Face Jobs 相同,只有 Docker 的选项不同。
# 预处理成隐表示
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN=hf_xxx \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-prep:latest \
  trellis2-prep --meshes your-username/my-meshes --push-to your-username/my-meshes-trellis2
LoRA 微调:
# 稀疏结构流 DiT
docker run --gpus all --rm --shm-size 16g \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config ss --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora --trackio-space your-username/trellis2-trackio

# 形状流 DiT
docker run --gpus all --rm --shm-size 16g \
  -v hf-cache:/root/.cache/huggingface -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train --config shape --latents your-username/my-meshes-trellis2 \
    --push-to your-username/my-trellis2-lora --trackio-space your-username/trellis2-trackio
如果你想在自己选的机器上用我们已经预处理好的数据集,用下面这些命令:
export HF_TOKEN=hf_xxx  # 把 your-username 换成你的 Hugging Face 用户名

# 稀疏结构流 DiT
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN \
  -v hf-cache:/root/.cache/huggingface \
  -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config ss \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500

# 形状流 DiT
docker run --gpus all --rm --shm-size 16g -e HF_TOKEN \
  -v hf-cache:/root/.cache/huggingface \
  -v "$PWD/work":/workspace/work \
  cr.hf.co/suvadityamuk/trellis2-finetuning-train:latest \
  trellis2-train \
    --config shape \
    --latents suvadityamuk/gso-footwear-trellis2-latents \
    --push-to your-username/trellis2-footwear-lora \
    --trackio-space your-username/trellis2-trackio \
    --set max_steps=3000 i_save=500
我们训练好的 LoRA 适配器在这个仓库:suvadityamuk/trellis-2-finetune-gso。
训练管线内部
预处理成隐表示
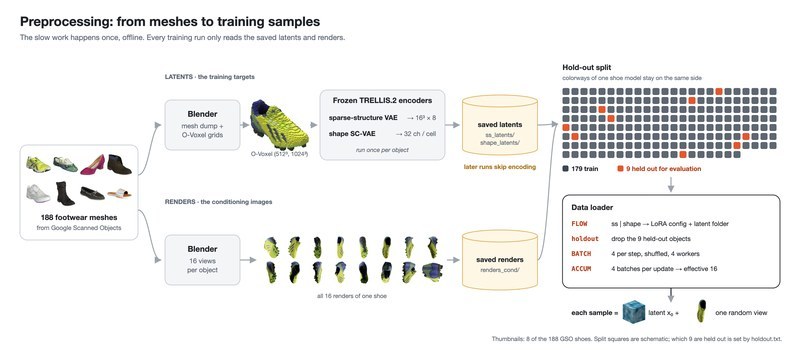
我们用 TRELLIS.2 冻结的编码器把输入网格转换成训练用隐表示。我们把这些隐表示保存下来,后续运行就不必再编码一遍网格。
我们还在 Blender 里为每个对象渲染 16 个视角。训练时,每个样本随机选一个视角作为条件图像。188 个对象里我们留 9 个做评测,其余 179 个用于训练。这些留出对象用来检验适配器在模型训练时没见过的对象上是否有效。
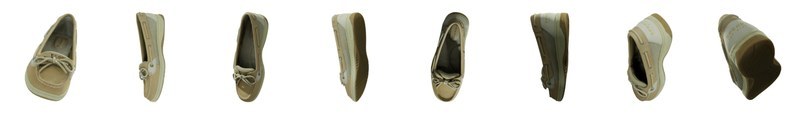
Blender 为一个对象渲染的部分视角
第一段代码准备数据。FLOW 选择要训练的流 DiT(ss 或 shape),STEPS 设置优化器步数。批大小 4、梯度累积 4 步,等效批大小为 16。然后这段代码加载所选流 DiT 的 LoRA 配置文件、按 TRELLIS.2 格式构建数据集、剔除留出对象,并建立微调用的数据加载器。
cfg = json.load(
    open(
        {
            "ss": "/workspace/TRELLIS.2/configs/lora/ss_flow_lora_gso.json",
            "shape": "/workspace/TRELLIS.2/configs/lora/slat_flow_img2shape_lora_gso.json",
        }[FLOW]
    )
)

key, latents = {
    "ss": ("ss_latent", "ss_latents/ss_enc_conv3d_16l8_fp16_64"),
    "shape": ("shape_latent", "shape_latents/shape_enc_next_dc_f16c32_fp16_512"),
}[FLOW]

roots = json.dumps(
    {
        "gso": {
            key: f"{DATA}/{latents}",
            "render_cond": f"{DATA}/renders_cond",
            "meta": DATA,
        }
    }
)

ds = getattr(datasets, cfg["dataset"])(roots, **cfg["dataset_args"])

holdout = set(open(f"{DATA}/holdout.txt").read().split())
ds.instances = [(root, sha) for root, sha in ds.instances if sha not in holdout]

batches = cycle(
    DataLoader(
        ds,
        batch_size=BATCH,
        shuffle=True,
        drop_last=True,
        num_workers=4,
        collate_fn=getattr(ds, "collate_fn", None),
    )
)
准备 LoRA 适配器
我们用 peft 库把 LoRA 适配器插入选定的层。TRELLIS.2 有自定义的前向过程,所以标准的 PeftModel() 包装器用不了。我们改用 inject_adapter_in_model(),它把适配器直接加到模型上,并保留模型的自定义接口。
为数值稳定性,我们把可训练的适配器权重保存在 32 位浮点(fp32),前向用 bfloat16(bf16)自动混合精度。自动混合精度让 PyTorch 对部分运算使用更低精度,从而减少内存占用;它不改变冻结骨干权重的存储方式。
model = models.from_pretrained(cfg["ckpt"])
for block in model.blocks:
    block.use_checkpoint = True

inject_adapter_in_model(
    LoraConfig(
        r=cfg["rank"], lora_alpha=cfg["alpha"], target_modules=cfg["lora_targets"]
    ),
    model,
)

params = []
for name, p in model.named_parameters():
    p.requires_grad_("lora_" in name)
    if p.requires_grad:
        p.data = p.data.float()  # LoRA 用 fp32 主权重
        params.append(p)

model.cuda().train()
训练
需要注意,我们这里的目标函数就是经典的 rectified flow matching(在 Stable Diffusion 3、Flux 2 等流行图像生成模型里都能看到)。TRELLIS.2 在预训练时用的是同一个目标,所以它适合微调。理论部分读这篇关于 flow matching 的博客。
我们只更新稀疏结构与形状这两个 DiT 里的 LoRA 参数。所有原始模型权重保持冻结。
下面的代码片段展示一个阶段的核心训练循环,比容器里的代码简单,省略了一些准备工作。完整流程请用容器命令。
我们初始化优化器,并加载 DINOv3 以从输入图像提取特征。
opt = torch.optim.AdamW(
    params, lr=cfg["lr"], weight_decay=cfg["weight_decay"], betas=(0.9, 0.95)
)

dino = DinoV3FeatureExtractor(
    cfg["image_cond_model"], image_size=cfg["image_size"]
).cuda()
然后在训练循环里按这些步骤走:
- 为每个样本采一个时间步 t(按 TRELLIS.2 配置:稀疏结构流 DiT 用 logitNormal,形状流 DiT 用均匀分布);
- 生成与数据形状匹配的随机噪声,并把 t 重排成可广播的形状;
- 按 t 把干净数据与噪声混合(t = 0 是噪声最少的数据,t = 1 是纯噪声);
- 在 t × 1000 处预测速度,以匹配预训练条件;
- 把损失算成「预测速度」与「目标速度」(x_t 的一阶导)之间的均方误差。
def flow_loss(x0, cond):
    s = cfg["t_schedule"]

    t = (
        torch.rand(x0.shape[0])
        if s["name"] == "uniform"
        else torch.sigmoid(
            torch.randn(x0.shape[0]) * s["args"]["std"] + s["args"]["mean"]
        )
    )
    t = t.cuda()

    noise = (
        x0.replace(torch.randn_like(x0.feats))
        if cfg["sparse"]
        else torch.randn_like(x0)
    )

    tv = t.view(-1, *[1] * (len(x0.shape) - 1))

    x_t = (1 - tv) * x0 + (cfg["sigma_min"] + (1 - cfg["sigma_min"]) * tv) * noise

    pred, target = model(x_t, t * 1000, cond), (1 - cfg["sigma_min"]) * noise - x0

    return (
        F.mse_loss(pred.feats, target.feats)
        if cfg["sparse"]
        else F.mse_loss(pred, target)
    )
训练循环计算损失并更新适配器权重。梯度累积在每次优化器步进前累加 4 个小批的梯度。梯度检查点通过在反向传播时重算部分中间值来省显存。外层循环跑给定数量的优化器步数,内层循环在一组批上累积梯度。
对每个批,DINOv3 编码条件图像。为做 classifier-free guidance(CFG)丢弃,循环会把随机比例(p_uncond)的样本条件置零。然后它用 bf16 自动混合精度算出 flow-matching 损失。内层循环结束后,它裁剪梯度以防过大更新,并做一次优化器步进。每 10 步记录一次损失,每 500 步保存一次适配器检查点。
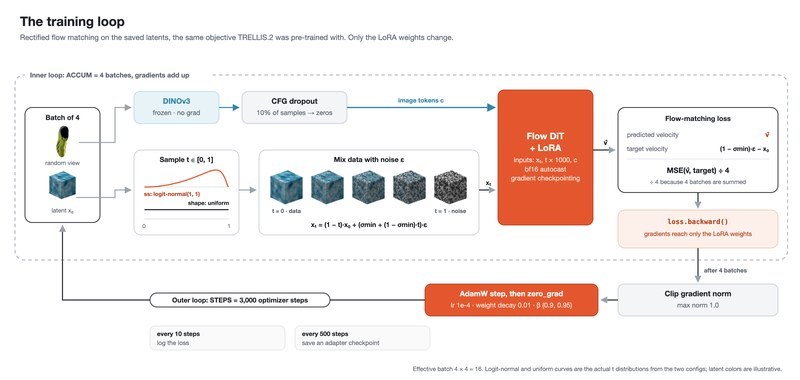
for step in range(1, STEPS + 1):
    for _ in range(ACCUM):
        batch = next(batches)
        x0 = recursive_to_device(batch["x_0"], "cuda")

        with torch.no_grad():
            cond = dino(batch["cond"])
            cond[torch.rand(len(cond), device="cuda") < cfg["p_uncond"]] = 0

        with torch.autocast("cuda", dtype=torch.bfloat16):
            loss = flow_loss(x0, cond) / ACCUM

            loss.backward()

    torch.nn.utils.clip_grad_norm_(params, cfg["grad_clip"])

    opt.step()
    opt.zero_grad()
结果
我们训练了两个适配器:一个给稀疏结构 DiT,一个给形状 DiT。容器镜像里的 LoRA 配置文件包含完整训练设置:稀疏结构流 DiT 用 ss_flow_lora_gso.json,形状流 DiT 用 slat_flow_img2shape_lora_gso.json。每次运行在 Hugging Face Jobs 上用一张 A100 80 GB。稀疏结构那次用了 7.2 小时,形状那次用了 3.6 小时。
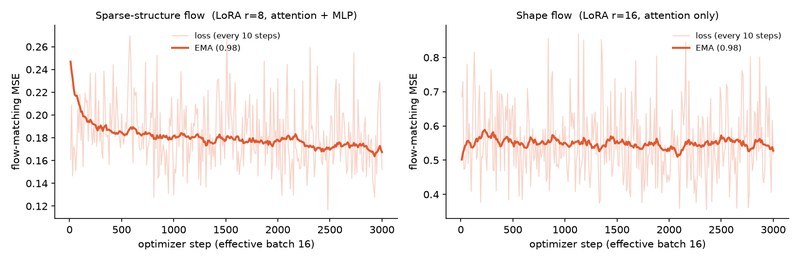
稀疏结构流 DiT 的训练损失在开始阶段下降很快,之后变慢。形状流 DiT 的损失则基本维持在同一水平。这些曲线显示了训练目标怎么变化,但并不直接衡量生成几何的质量。
Flow-matching 损失会随采到的对象、噪声与时间步波动。要判断微调是否改善了几何,还必须比较留出对象上的输出。
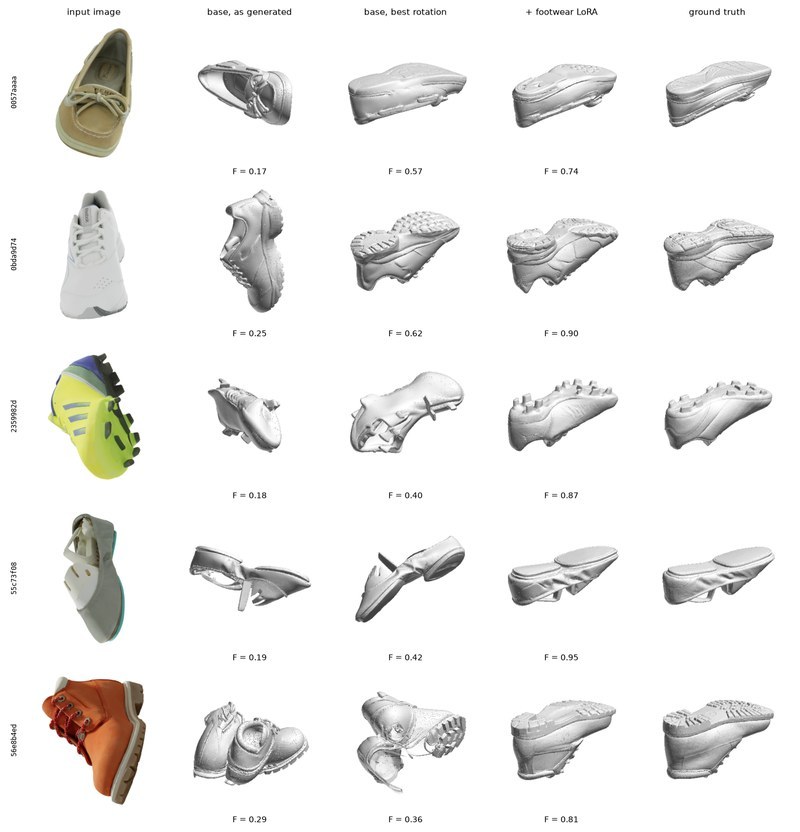
下图比较了 9 个留出对象中 5 个的输出:输入图像、基础模型的生成结果、旋转对齐后的基础输出、带鞋类适配器的输出,以及参考扫描。在这些例子里,微调模型的鞋底更接近扫描。
我们还用三个指标在测试集上评估几何:
| 指标 | 含义 |
|---|---|
| Chamfer 距离 | 从一个表面上的点到另一个表面上最近点的距离,双向测量。越低越好。 |
| F-score @ 0.02 | 精确率(生成的表面有多少落在参考附近)与召回率(参考表面有多少被生成表面覆盖)的组合。这里匹配阈值是扫描包围盒对角线的 2%。越高越好。 |
| 法线一致性 | 表面朝向的一致程度。表面法线是垂直于表面的向量。越高越好。 |
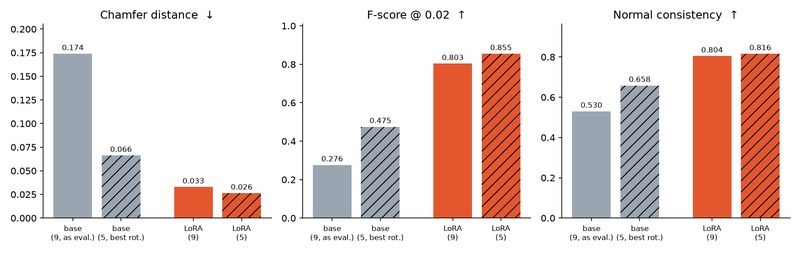
在九个对象的对比里,基础模型的平均 F-score 是 0.276,带鞋类适配器的模型是 0.803。Chamfer 距离从 0.174 降到 0.033,法线一致性从 0.530 升到 0.804。两个适配器一起用时,九个留出对象上的 F-score 全部更好。
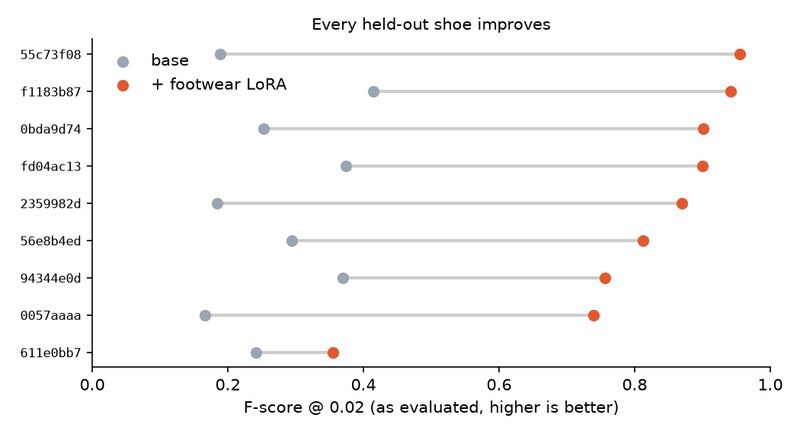
所有运行的统计见这个 Trackio 空间。
未来方向
呼,就是这样!我们通过给控制几何的两个模型组件加 LoRA 适配器,把 TRELLIS.2 微调到了鞋类生成上。数据只准备一次,适配器分开两个任务训练,然后在留出对象上评估输出。
主要的经验是:选一个与你的问题和数据相匹配的训练目标。 在这个实验里,我们微调了结构与形状两个阶段,冻结了纹理阶段。
接下来可以考察同样的选择是否对别的 3D 生成模型也有效,比如 Pixal3D 和 UniLat3D。
高斯泼溅与世界生成类模型,比如 HunyuanWorld 2.0 和 NVIDIA Lyra 2.0,也是可能的下一步。它们的表示与训练管线可能需要不同的方法。
感谢一路读到这里,下一篇见!👋🤗
落到工具上:微调之后怎么验
这篇的价值不在于「LoRA 好用」,而在于它把「只训该训的那一段」讲成了可执行的判断:先看管线哪一段决定你要的那个属性(这里是鞋底 → 形状流),再看你的数据集能不能支撑那一段(纹理阶段缺独立材质图,所以冻结)。这两条判断可以直接搬到别的 3D 生成模型上。
微调跑完之后,验收有三个层次,按成本从低到高:
- 能不能打开。 先看导出的 GLB 在独立查看器里是否正常——材质、法线、朝向有没有跟着塌。这一步不花时间,却能拦掉一大类「指标好看、文件没用」的结果。
- 该像的地方像不像。 用同一批留出对象的原始图像当输入,肉眼对齐你关心的那个局部(鞋底、接口、螺纹),而不是整体相似度。
- 指标是否与肉眼一致。 F-score、Chamfer、法线一致性三者要一起看:F-score 高但法线一致性低,说明形状对了、朝向错了,接到后续管线(切片、渲染、仿真)会出问题。
如果你只是想先拿一版 3D 资产看效果、还没到训练阶段,可以用 文字/图片转 3D 出一个初版;微调产出的 GLB 想快速目视核对,直接拖进 3D 模型查看器 就行。
同主题的历史文章:
- PEFT 的 LoraConfig 参数详解:本文里
r与lora_alpha那两个数字从哪来、怎么调; - 水密不等于可打印:AI 3D 资产的验收:指标通过之后仍然会翻车的那些检查;
- AI 3D 资产交接的五个检查:从「生成了一个模型」到「别人能用这个模型」之间的清单。
专题入口:AI × 3D / 生成式 AI 完全指南。
来源:The Definitive Fine-Tuning Guide for 3D Generation Models(Suvaditya Mukherjee、Merve,Hugging Face Blog,2026-11-12)。
本文由 BimAnt 编译整理,转载请注明出处。
本文属于「AI × 3D」专题。查看专题全部文章 →


